Articolo
Far parlare i dati di gestionali diversi: il metodo in sei passi
Hai deciso di collegare i dati tra gestionali, ecommerce ed Excel? Il metodo ETL in sei passi: fonti, regole, staging, log, test e automazione, con un caso reale.
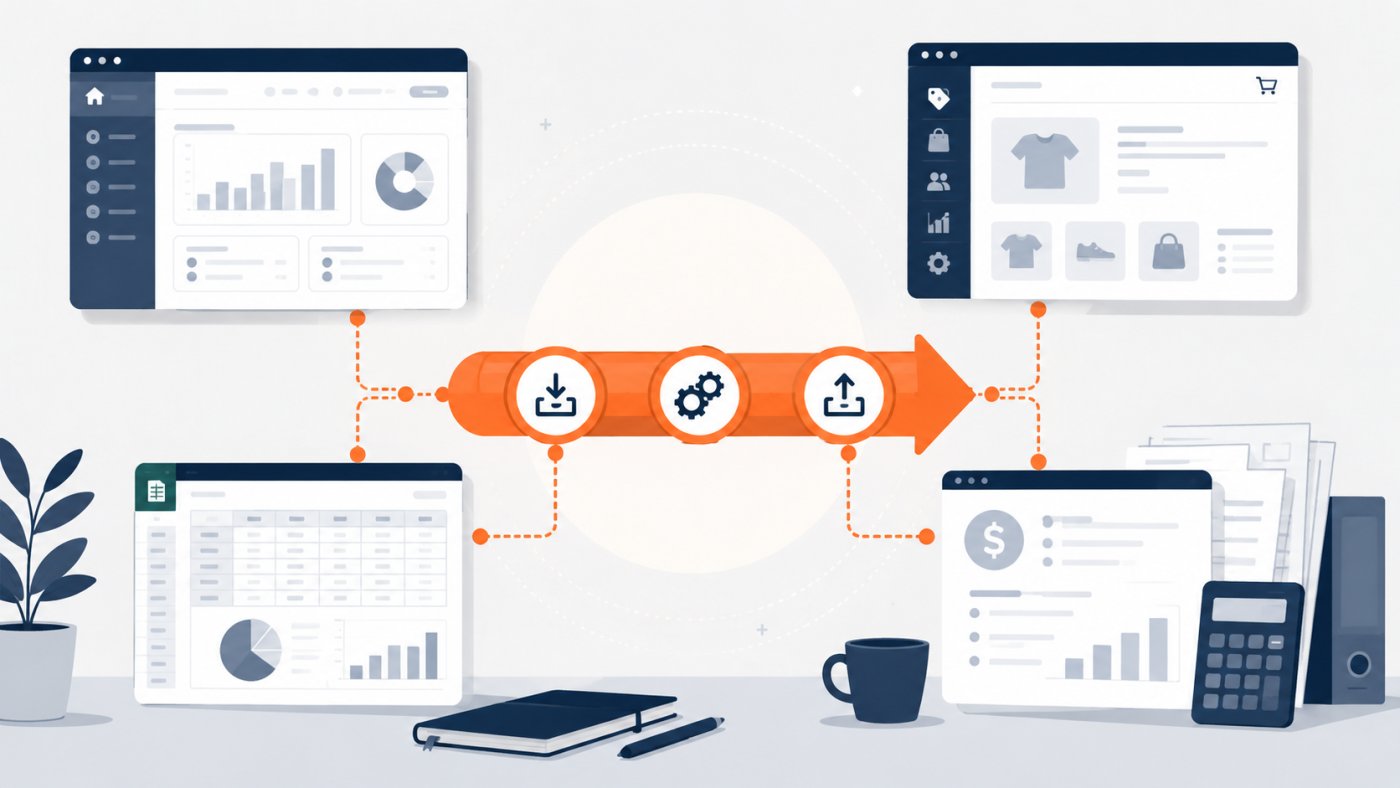
- L’ETL aiuta una PMI a collegare dati che oggi vivono in gestionali, e-commerce, fogli Excel e contabilità separati
- Prima di scrivere codice serve mappare fonti, campi, regole e responsabilità sui dati
- Un buon flusso ETL deve avere controlli, log, gestione degli errori e dati di test
- Integrare dati non significa solo spostarli, ma renderli coerenti, tracciabili e utili per decidere
Questa guida parte da una decisione già presa: collegare i programmi che hai, invece di cambiarli. Se sei ancora a quel bivio, leggi prima Cambiare gestionale o integrare meglio. Qui trovi il metodo che usiamo per far parlare i dati: sei passi, dalla mappa delle fonti al controllo dei risultati.
Perché i dati aziendali smettono di parlarsi
In una PMI, i sistemi nascono spesso in momenti diversi. Prima arriva il gestionale. Poi arriva l’e-commerce. Dopo si aggiunge un software per la fatturazione, un CRM, un foglio Excel o un portale fornitori.
Ogni strumento risolve un problema specifico. Tuttavia, nel tempo crea anche un nuovo contenitore di dati. Quindi la stessa informazione inizia a esistere in più punti. Un cliente può avere un nome nel gestionale, un altro nome nell’e-commerce e un codice diverso in contabilità.
Questa frammentazione produce tre problemi pratici. Il primo è la perdita di tempo. Le persone copiano dati da un sistema all’altro. Il secondo è l’errore umano. Un codice prodotto copiato male può bloccare un ordine. Il terzo è la mancanza di fiducia. Se due report danno numeri diversi, nessuno sa quale usare.
Quando due sistemi mostrano valori diversi per lo stesso cliente, prodotto o documento, non hai solo un problema di report. Hai un problema di processo.
Per questo un progetto ETL deve partire dal flusso di lavoro, non dal codice. Prima devi capire chi crea il dato, chi lo modifica, chi lo usa e quale sistema deve essere considerato la fonte corretta.
Cos’è un flusso ETL, in parole semplici
Collegare i dati con un flusso ETL significa creare una sequenza chiara. Prima estrai i dati dalle fonti. Poi li trasformi secondo regole note. Infine li carichi nel sistema di destinazione.
Questa sequenza sembra semplice, ma richiede disciplina. Se salti la fase di analisi, rischi di spostare dati sbagliati più velocemente. L’automazione non corregge un processo confuso. Al contrario, lo rende più veloce e più difficile da fermare.
Extract: estrarre i dati dalle fonti
La fase di estrazione serve a leggere i dati dai sistemi esistenti. Le fonti più comuni sono database, file CSV, API, export Excel e cartelle condivise. Ogni fonte ha vincoli diversi.
Un file CSV è semplice, ma può cambiare colonne senza preavviso. Un’API è più stabile, ma richiede credenziali, limiti di chiamata e gestione degli errori. Un database è potente, ma va interrogato con attenzione per non bloccare il lavoro operativo.
Un esempio minimo di file ordini può essere questo:
order_id,customer_code,sku,quantity,total,date
1001,C001,SKU-RED-42,2,89.90,2026-06-01
1002,C014,SKU-BLU-39,1,49.90,2026-06-01
1003,C001,SKU-GRN-40,3,119.70,2026-06-02
La documentazione ufficiale di Python include il modulo Python csv (si apre in una nuova scheda), utile per leggere file CSV in modo controllato.
Transform: trasformare i dati
La trasformazione rende i dati coerenti. In questa fase puoi normalizzare date, pulire codici, unire campi, convertire valute, rimuovere duplicati e controllare valori mancanti.
Per esempio, un gestionale può usare il formato data italiano, mentre un e-commerce può esportare date in formato ISO. Senza una regola comune, i report diventano fragili.
from datetime import datetime

def normalizza_data(valore):
    formati = ["%d/%m/%Y", "%Y-%m-%d"]
    for formato in formati:
        try:
            return datetime.strptime(valore, formato).date().isoformat()
        except ValueError:
            pass
    raise ValueError(f"Formato data non valido: {valore}")

print(normalizza_data("01/06/2026"))
print(normalizza_data("2026-06-01"))
Questo esempio non è un progetto completo. Serve però a mostrare un punto importante: la regola deve essere esplicita. Se una persona corregge le date a mano, il controllo resta nella sua testa. Se una funzione lo fa sempre nello stesso modo, il processo diventa ripetibile.
Load: caricare i dati nel sistema giusto
Il caricamento porta i dati trasformati nel sistema di destinazione. Può essere un database, un gestionale, un data warehouse o un file condiviso. In questa fase devi evitare duplicati e carichi parziali.
Una buona pratica è caricare prima i dati in una tabella temporanea, detta anche tabella di staging. Poi controlli i dati e solo dopo aggiorni le tabelle finali.
CREATE TABLE staging_orders (
  order_id TEXT,
  customer_code TEXT,
  sku TEXT,
  quantity INTEGER,
  total NUMERIC,
  order_date DATE
);
Se usi PostgreSQL, il comando COPY è uno strumento comune per caricare dati da file. La documentazione ufficiale descrive il comando PostgreSQL COPY (si apre in una nuova scheda).
Passo 1: mappa fonti, campi e proprietari del dato
Prima di integrare sistemi, crea una mappa dei dati. Non deve essere complessa. Può partire da un foglio condiviso con tre colonne: fonte, campo, significato.
Per ogni dato importante, chiediti dove nasce. Il cliente nasce nel CRM o nel gestionale? Il prezzo nasce nell’e-commerce o nel listino interno? La giacenza nasce dal magazzino o dagli ordini online?
Questa domanda definisce la fonte autorevole. Senza una fonte autorevole, ogni integrazione diventa una trattativa tra sistemi. Il risultato è fragile, perché ogni software può avere una versione diversa della verità.
- Clienti: fonte autorevole nel gestionale
- Ordini: fonte autorevole nell’e-commerce
- Giacenze: fonte autorevole nel sistema di magazzino
- Fatture: fonte autorevole nel sistema contabile
Scegli una sola fonte autorevole per ogni dato critico. Se due sistemi possono modificare lo stesso campo, definisci una regola chiara di precedenza.
Questa fase aiuta anche a capire quali campi servono davvero. Molti export contengono decine di colonne inutili. Portarle tutte nel flusso ETL aumenta rumore, tempi e rischi.
Passo 2: definisci le regole di trasformazione
La trasformazione è il cuore del lavoro. Qui decidi come rendere compatibili dati che arrivano da sistemi diversi. Per collegare i dati in modo affidabile, devi scrivere regole semplici e verificabili.
Le regole più comuni riguardano codici, date, importi, stati documento e anagrafiche. Per esempio, un ordine può avere stato “paid” nell’e-commerce e “pagato” nel gestionale. Non sono valori diversi nel significato, ma lo sono per una macchina.
{
  "paid": "pagato",
  "pending": "in_attesa",
  "cancelled": "annullato",
  "refunded": "rimborsato"
}
Questa tabella di mapping evita interpretazioni manuali. Inoltre, rende più facile spiegare il flusso a chi lavora in amministrazione o in magazzino.
Devi poi gestire i valori mancanti. Un ordine senza codice cliente va scartato, corretto o caricato con un valore provvisorio? Non esiste una risposta valida per tutte le aziende. Però la regola deve essere decisa prima.
def valida_riga_ordine(riga):
    errori = []
    if not riga.get("order_id"):
        errori.append("order_id mancante")
    if not riga.get("customer_code"):
        errori.append("customer_code mancante")
    if int(riga.get("quantity", 0)) <= 0:
        errori.append("quantity non valida")
    return errori
Questo tipo di controllo riduce casi ambigui. Inoltre, permette di creare un report errori utile per correggere i dati alla fonte.
Passo 3: usa staging, controlli e log
Un errore comune è caricare subito i dati trasformati nel sistema finale. Sembra più veloce, ma aumenta il rischio. Se qualcosa va storto, diventa difficile capire quale riga ha creato il problema.
La tabella di staging funziona come una zona di controllo. I dati arrivano lì prima di entrare nel processo operativo. Puoi controllarli, contarli, confrontarli e validarli.
SELECT COUNT(*) AS righe_totali FROM staging_orders;

SELECT sku, SUM(quantity) AS pezzi_venduti
FROM staging_orders
GROUP BY sku
ORDER BY pezzi_venduti DESC;
Accanto alla staging, devi creare log chiari. Un log deve dire quando il flusso è partito, quante righe ha letto, quante ne ha scartate e perché. Non serve un sistema complesso all’inizio. Serve però una traccia leggibile.
{
  "job": "import_ordini_ecommerce",
  "started_at": "2026-06-08T08:00:00",
  "rows_read": 250,
  "rows_loaded": 247,
  "rows_rejected": 3,
  "status": "completed_with_warnings"
}Un flusso ETL senza log può funzionare per mesi, ma diventa difficile da gestire quando compare il primo errore serio.
Se tratti dati personali, devi anche considerare sicurezza, accessi e basi giuridiche. Per un riferimento istituzionale sul quadro europeo, puoi consultare la pagina ufficiale della Commissione Europea sulla protezione dei dati (si apre in una nuova scheda).
Passo 4: automatizza il flusso senza perdere controllo
Dopo aver testato estrazione, trasformazione e caricamento, puoi automatizzare il flusso. Tuttavia, automazione non significa assenza di controllo. Significa ridurre lavoro manuale mantenendo regole, log e notifiche.
Per una PMI, un primo livello può essere un job schedulato ogni notte. In altri casi serve un flusso più frequente, per esempio ogni ora. La scelta dipende dal processo. Lo stock e gli ordini spesso richiedono tempi più stretti. I report direzionali possono aggiornarsi una volta al giorno.
0 2 * * * /usr/bin/python3 /opt/etl/import_ordini.py >> /var/log/etl_ordini.log 2>&1Questo esempio mostra una pianificazione notturna con cron. È semplice, ma già utile. Il punto essenziale è registrare l’esito e controllare gli errori.
Devi anche definire chi riceve gli avvisi. Se il flusso fallisce, il problema deve arrivare a una persona responsabile. Non deve restare nascosto in un file di log che nessuno apre.
- Errore bloccante: avviso immediato al referente operativo
- Righe scartate: report giornaliero al reparto interessato
- Carico completato: log consultabile senza notifica
- Dati anomali: controllo manuale prima del caricamento finale
Questa distinzione evita rumore. Se mandi email per ogni evento, le persone smettono di leggerle. Se avvisi solo quando serve, il controllo resta efficace.
Passo 5: testa il flusso con casi reali
Un flusso ETL non va testato solo con dati perfetti. Deve funzionare anche con dati sporchi, incompleti o inattesi. Per questo devi creare un set di test realistico.
Inserisci casi normali, duplicati, codici mancanti, date errate e importi negativi. Poi verifica cosa succede. Il sistema deve caricare ciò che è corretto e isolare ciò che richiede attenzione.
order_id,customer_code,sku,quantity,total,date
1004,C021,SKU-WHT-41,1,59.90,2026-06-03
1004,C021,SKU-WHT-41,1,59.90,2026-06-03
1005,,SKU-BLK-44,2,99.80,2026-06-03
1006,C034,SKU-RED-42,-1,-49.90,errore_data
Questo esempio contiene un duplicato, un cliente mancante, una quantità negativa e una data non valida. Sono casi semplici, ma molto comuni nei flussi reali.
Il test deve rispondere a domande pratiche. Il duplicato viene bloccato? La riga senza cliente va in errore? L’importo negativo è previsto per un reso o è un problema? Senza queste risposte, l’automazione resta fragile.
Non testare solo il caso felice. I processi aziendali si rompono quasi sempre sui casi limite.
Passo 6: misura il risultato e migliora il processo
Quando il flusso ETL è partito, devi misurarne l’impatto. Non servono decine di indicatori. Bastano pochi numeri utili.
- Righe elaborate per giorno
- Righe scartate per errore
- Tempo medio di correzione
- Numero di interventi manuali evitati
- Frequenza degli errori ripetuti
Questi dati ti aiutano a migliorare il processo. Se molte righe vengono scartate per lo stesso motivo, forse la fonte genera dati incompleti. Se servono molte correzioni manuali, forse una regola di trasformazione non è chiara.
La misurazione serve anche a parlare con il team. Un progetto ETL funziona meglio quando le persone capiscono il vantaggio pratico. Meno copia e incolla significa meno errori, meno urgenze e più tempo per controlli di valore.
Un caso reale. Un ecommerce riceveva merce da più fornitori, ognuno con i suoi formati e i suoi codici. È un lavoro ETL tipico: il sistema che abbiamo costruito legge i codici a barre dai documenti (estrazione), li riporta ai codici del catalogo (trasformazione) e aggiorna le disponibilità (caricamento). Lo stock si aggiorna in pochi minuti invece che in ore, e dopo l’implementazione gli errori di stock sono spariti. Guarda il caso.
Errori comuni da evitare in un progetto ETL
Il primo errore è partire dallo strumento. Molte aziende cercano subito una piattaforma, uno script o un connettore. Invece, dovrebbero partire dal processo. Senza regole chiare, anche lo strumento migliore produce confusione.
Il secondo errore è integrare tutto subito. Una PMI dovrebbe partire da un flusso ad alto impatto, come ordini e stock oppure fatture fornitori. Dopo aver stabilizzato quel processo, può estendere il metodo ad altri dati.
Il terzo errore è non coinvolgere chi usa i dati ogni giorno. Il reparto amministrativo conosce eccezioni che il reparto tecnico non vede. Il magazzino sa quali codici creano confusione. Le vendite sanno quali campi servono davvero per seguire il cliente.
Il quarto errore è non prevedere manutenzione. I sistemi cambiano, i campi cambiano e i processi cambiano. Quindi anche il flusso ETL va rivisto nel tempo.
Un buon ETL non è solo uno script che gira. È un processo documentato, controllato e comprensibile anche quando qualcosa va storto.
Conclusione: i dati devono seguire il lavoro, non ostacolarlo
Quando i dati non si parlano, le persone fanno da ponte. Copiano, correggono, confrontano e ricostruiscono. Questo lavoro sembra normale, ma consuma tempo e aumenta il rischio.
Un flusso ETL ben progettato cambia il modo in cui una PMI lavora. Non elimina il controllo umano, ma lo sposta nel punto giusto. Le persone non devono più copiare dati. Devono controllare eccezioni, decidere regole e migliorare il processo.
Far parlare i dati significa rendere i sistemi più coerenti e il lavoro più fluido. Parti da un processo critico, mappa le fonti, scrivi le regole, crea staging e log, testa casi reali e automatizza con controllo.
Non serve fare tutto in una volta. Serve iniziare dal punto in cui la frammentazione costa di più. Da lì, l’ETL diventa un modo pratico per far parlare i dati e ridurre il peso operativo sul team.